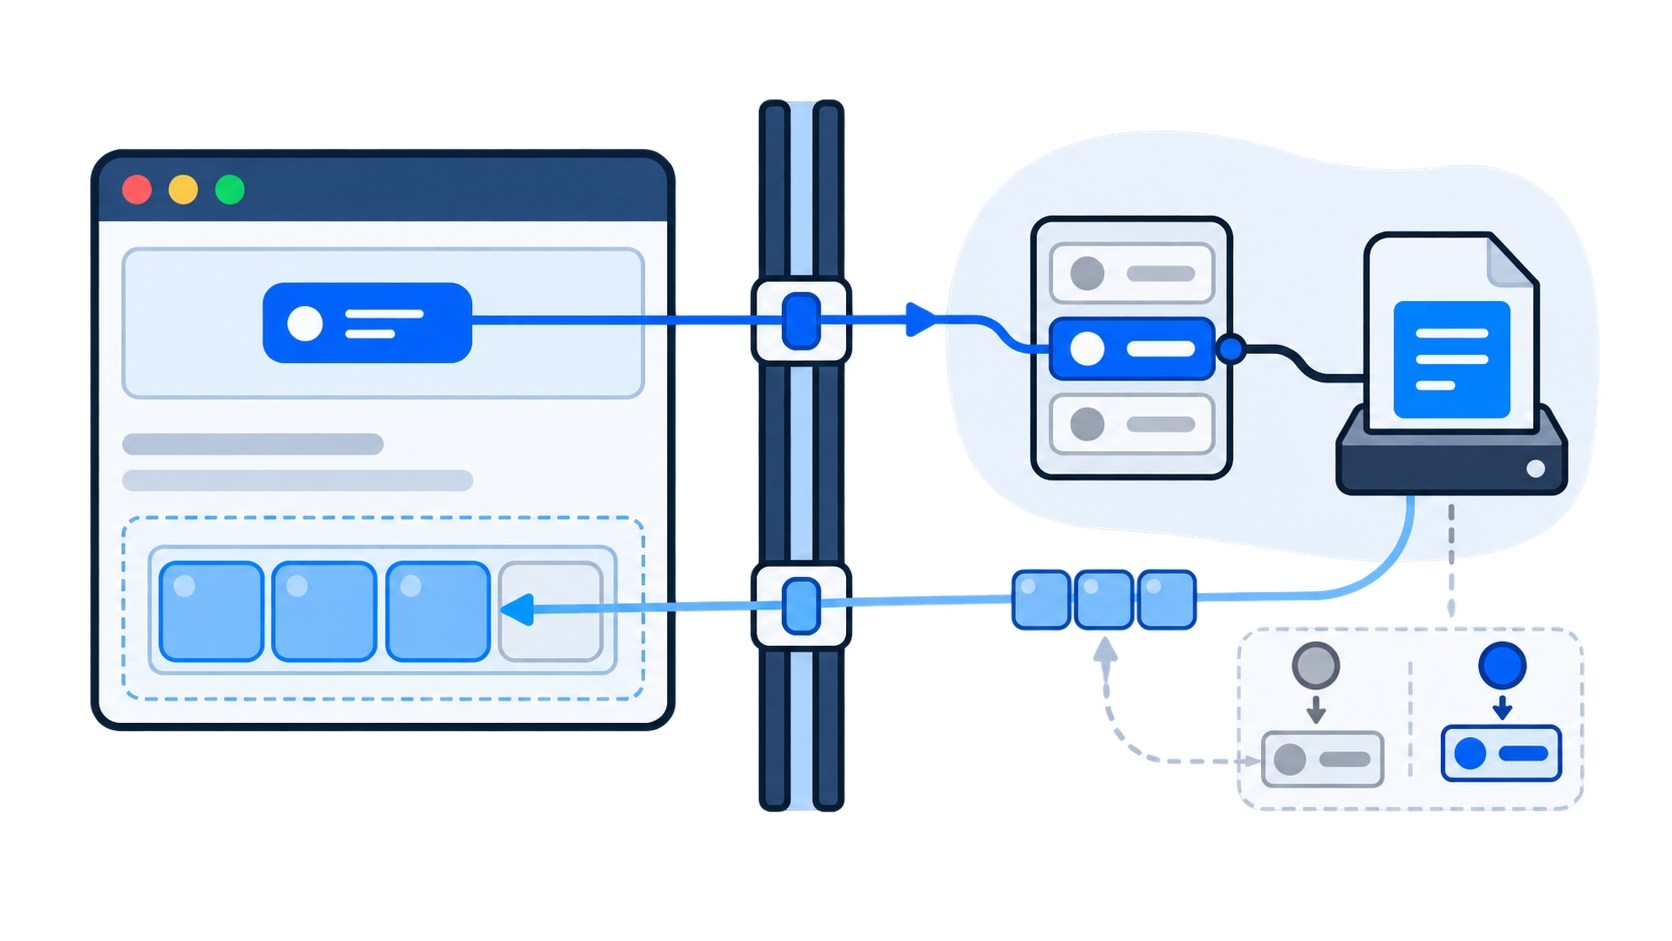
프로그램은 데이터를 읽으며 움직인다. 설정은 파일에서, 요청은 소켓에서, 프로그램 사이의 메시지는 파이프에서 들어온다.
파일, 소켓과 파이프는 서로 다른 대상이지만 Linux는 이들을 read()라는 공통 인터페이스로 읽게 한다.
ssize_t bytes = read(fd, buffer, size);애플리케이션 코드에서 보이는 읽기는 이 한 줄뿐이다. 먼저 어려운 이름을 역할로 바꾸면 코드가 묻는 질문은 단순해진다.
무엇을 → fd
어디에 → buffer
얼마나 → size
그런데 이 코드에는 파일 경로도, 저장 장치 이름도, 기다리는 방법도 적혀 있지 않다. 애플리케이션이 직접 넘기는 것은 fd, buffer, size 세 값뿐이다.
운영체제는 이 세 값을 출발점으로 읽을 대상과 데이터를 받을 범위를 찾는다. 기다릴지는 열린 대상의 설정과 데이터 준비 상태에 따라 판단한다.
세부 용어를 붙이기 전에 전체 경로부터 보면 다음과 같다.
애플리케이션
read(무엇을, 어디에, 얼마나)
        │
        ▼
운영체제에 읽기 요청
        │
        ▼
대상 찾기 → 받을 곳 확인 → 필요하면 기다리기
        │
        ▼
데이터를 옮기고 결과 반환
        │
        ▼
애플리케이션이 read() 다음 줄부터 계속 실행
이 글은 Linux의 일반적인 블로킹 read() 한 번을 이 순서대로 따라간다.
파일, 파이프와 소켓이 내부에서 데이터를 준비하는 세부 방식은 다음 단계로 미룬다.
read()는 운영체제에 읽기를 맡기는 요청이다
애플리케이션이 저장 장치나 네트워크 장치에서 직접 데이터를 가져오면 안 될까?
일반적인 애플리케이션은 장치를 마음대로 제어할 수 없다. 여러 프로그램이 같은 CPU, 메모리와 장치를 함께 사용하기 때문에 누가, 언제, 어디까지 접근할 수 있는지를 운영체제가 통제해야 한다.
그 통제를 맡는 운영체제의 중심부가 커널이다. 커널은 애플리케이션과 하드웨어 사이에서 요청을 확인하고, 필요한 자원을 사용해 실제 작업을 처리한다.
애플리케이션이 커널에 일을 요청할 때 사용하는 정해진 입구를 시스템 콜이라고 한다. read()는 그 입구를 통해 커널에 “이 대상의 데이터를 이 공간에 이만큼 읽어 달라”고 맡기는 요청이다.
read()를 호출한 같은 실행 흐름이 커널로 들어가 읽기를 처리한 뒤 원래 자리로 돌아온다.
이 과정에서 새 프로세스가 생기는 것은 아니다. 애플리케이션 코드를 실행하는 사용자 모드에서 커널 코드를 실행하는 커널 모드로 전환했다가, 결과를 가지고 다시 사용자 모드로 돌아온다.
실제 C 프로그램이 부르는 것은 보통 C 라이브러리가 제공하는 read() 함수다. 이 함수가 세 인자를 Linux가 약속한 방식으로 전달해 커널의 읽기 처리로 연결한다.
경계를 넘은 커널은 먼저 세 인자 가운데 fd를 보고 무엇을 읽어야 하는지 찾는다.
fd는 무엇을 읽을지 알려 준다
read()에는 파일 경로가 없다. 읽을 대상은 그보다 먼저 정해지기 때문이다. 프로그램이 파일을 열거나 소켓을 만들면 커널은 그 대상을 현재 프로세스에 등록하고 작은 정수 하나를 돌려준다. 그 정수가 파일 디스크립터이고 코드에서는 보통 fd라고 쓴다.
예: fd 3
  │
  ▼
현재 프로세스가 열어 둔 대상 목록
  │
  ▼
실제 파일, 파이프 또는 소켓fd는 파일 경로나 데이터 자체가 아니라, 이미 열어 둔 입출력 대상을 찾는 작은 정수다.
각 프로세스는 자신이 열어 둔 대상 목록을 따로 가진다. 따라서 서로 다른 프로세스가 같은 fd 값 3을 사용하더라도, 한쪽은 파일을 다른 쪽은 소켓을 가리킬 수 있다.
이 방식 덕분에 애플리케이션은 저장 장치와 네트워크 장치의 세부 명령을 각각 배울 필요가 없다. 무엇을 열었든 그 번호를 read()에 전달해 같은 형태로 읽기를 요청할 수 있다.
이제 커널은 무엇을 읽을지 찾았다. 하지만 읽은 데이터를 buffer에 써도 되는지는 아직 확인하지 않았다.
buffer와 size는 어디에 얼마나 담을지 알려 준다
읽을 대상을 찾았다면 가져온 데이터를 놓을 곳이 필요하다. 애플리케이션은 데이터를 받기 전에 메모리 공간을 마련해 둔다. buffer는 그 공간이 시작되는 위치이고, size는 그곳에 최대 몇 바이트까지 받을 수 있는지 알려준다.
현재 프로세스의 메모리

buffer가 가리키는 시작점
        │
        ▼
        [ 데이터를 받을 수 있는 공간 ]
└──── 최대 size 바이트 ────┘read()가 새 버퍼를 만드는 것이 아니라, 애플리케이션이 준비한 기존 메모리 범위를 커널이 채운다.
buffer가 가리키는 위치는 가상 주소다. 각 프로세스는 자기만의 주소 공간을 가지므로 같은 주소값이라도 다른 프로세스에서는 다른 메모리를 가리킬 수 있다. 이 주소 공간을 실제 메모리와 연결하고 서로 보호하는 체계가 가상 메모리다.
커널은 애플리케이션이 넘긴 주소를 무조건 믿지 않는다. 현재 프로세스가 해당 메모리 범위에 데이터를 쓸 수 있는지 확인하며, 허용된 범위에만 읽은 데이터를 옮긴다.
대상과 목적지가 정해졌다면 남은 질문은 하나다. 요청한 데이터가 지금 바로 준비되어 있는가.
데이터가 없으면 호출한 스레드가 기다린다
데이터가 아직 준비되지 않았다면 컴퓨터 전체가 멈추는 걸까?
그렇지 않다. read()를 호출한 스레드는 반환값을 받아야 다음 줄로 진행할 수 있지만, 다른 스레드까지 함께 멈춰야 하는 것은 아니다.
데이터가 준비되었는가?
        │
   ┌────┴────┐
  Yes        No
   │          │
데이터를     호출한 스레드를
buffer로     대기 상태로 바꾼다
옮긴다        │
   │          ▼
   │       실행 가능한 다른 스레드가
   │       CPU를 사용할 수 있다
   │          │
   │       데이터가 준비된다
   │          │
   └────┬─────┘
        ▼
read()를 마치고 반환한다
이때 기다리는 것은 CPU 전체가 아니라 호출한 스레드다.
호출한 스레드가 대기 상태에 있는 동안에는 실행할 준비가 된 다른 스레드가 CPU를 사용할 수 있다. 다음에 어떤 스레드가 CPU를 사용할지 고르는 일을 CPU 스케줄링이라고 한다.
데이터가 준비되면 기다리던 스레드는 다시 실행할 수 있는 상태가 된다. 이후 스케줄러의 선택을 받으면 멈췄던 read()를 마치고 실행을 이어 간다. 느린 입출력을 기다리는 동안에도 다른 프로그램이 실행될 수 있는 이유다.
이제 데이터가 buffer에 놓였다. 마지막으로 커널은 이번 요청이 어떻게 끝났는지 알려줘야 한다.
반환값은 읽기가 어떻게 끝났는지 알려 준다
read()는 끝났다는 사실만 알리지 않는다. 커널은 데이터를 buffer에 옮긴 뒤 실제로 몇 바이트를 읽었는지 반환한다. 애플리케이션은 이 값을 보고 이번 읽기의 결과와 버퍼에서 사용해도 되는 범위를 함께 판단한다.
반환값을 담는 ssize_t는 양수인 바이트 수뿐 아니라 0과 오류를 뜻하는 -1도 표현할 수 있는 정수형이다.
반환값 > 0  → 실제로 읽은 바이트 수
반환값 = 0  → 입력의 끝(EOF)
반환값 = -1 → 읽기 실패
요청한 size보다 작은 양수가 돌아와도 정상일 수 있다.
예를 들어 1,024바이트를 요청했지만 현재 준비된 데이터가 300바이트라면 read()는 300을 반환할 수 있다. 이때 애플리케이션은 요청한 1,024바이트가 아니라 반환된 300바이트만 이번에 읽은 데이터로 다뤄야 한다.
오류에서는 -1이 반환되고 오류 원인을 나타내는 코드가 errno에 남는다. 처리가 끝나면 같은 스레드가 사용자 모드로 돌아와 read() 다음 줄부터 실행을 계속한다.
반환값은 부가 정보가 아니라 읽기의 범위를 결정하는 계약이다.
흐름이 달라지는 경우
조건이 달라져도 큰 구조는 그대로지만 중간의 판단 결과는 달라질 수 있다. 실제 read()에는 기본 흐름에서 갈라지는 조건이 있다.
지금까지는 블로킹 방식의 일반적인 경로를 따라왔다. 논블로킹으로 설정된 대상은 데이터가 없을 때 스레드를 기다리게 하지 않는다. 대신 read()가 -1을 반환하고 errno에 EAGAIN 또는 EWOULDBLOCK을 남길 수 있다.
메모리 주소를 확인하는 과정도 항상 성공하지는 않는다. 현재 프로세스가 사용할 수 없는 주소라면 EFAULT로 실패할 수 있고, 필요한 메모리 페이지가 준비되지 않았다면 가상 메모리 관리 과정이 개입할 수 있다. 파일, 파이프와 소켓은 데이터를 준비하는 내부 과정도 서로 다르다.
이 차이들은 앞에서 본 큰 흐름을 뒤집지 않는다.
무엇을 읽을지 찾고, 어디에 담을지 확인하고, 지금 완료할 수 있는지 판단한 뒤 결과를 돌려준다는 구조 안에서 갈라지는 조건들이다.
이 한 줄이 보여주는 운영체제의 역할
그렇다면 짧은 read() 한 줄 아래에서 운영체제는 결국 무엇을 한 걸까?
처음에 본 세 인자와 반환값을 다시 놓고 보면 운영체제가 맡은 일이 선명해진다.
| 읽기 요청의 질문 | 따라갈 단서 | 운영체제가 하는 일 |
|---|---|---|
| 무엇을 읽을까 | fd |
현재 프로세스가 열어 둔 대상 하나를 찾는다 |
| 어디에 얼마나 쓸까 | buffer, size |
현재 프로세스가 사용할 수 있는 메모리 범위를 다룬다 |
| 지금 읽을 수 없다면 어떻게 할까 | 블로킹 상태 | 호출한 스레드를 기다리게 하고 실행 가능한 다른 흐름이 CPU를 사용하게 한다 |
| 읽기가 어떻게 끝났을까 | 반환값 | 실제 바이트 수, 입력의 끝 또는 오류를 알려준다 |
결과적으로 read()는 데이터를 가져오는 함수에 그치지 않는다. 애플리케이션이 직접 다루기 어려운 대상 선택, 메모리 보호와 대기 관리를 운영체제에 맡기고 결과를 돌려받는 접점이다.
코드 한 줄이 짧은 이유는 복잡성이 사라져서가 아니라, 운영체제가 복잡성을 일관된 계약 안에 감췄기 때문이다.
이번 글에서는 먼저 역할을 따라간 뒤 그 역할에 시스템 콜, 파일 디스크립터, 가상 메모리와 CPU 스케줄링이라는 이름을 붙였다. 다음 글에서는 이런 관리 체계가 왜 필요해졌는지 운영체제의 등장 배경으로 거슬러 올라간다.
read()와 운영체제의 자원 관리
- 커널Kernel
- CPU, 메모리와 장치를 관리하고 애플리케이션의 요청을 처리하는 운영체제의 중심부다.
read()가 시스템 콜 경계를 넘으면 커널이 실제 읽기 작업을 맡는다. - 시스템 콜System Call
- 애플리케이션이 Linux 커널에 기능을 요청하는 기본 인터페이스다.
read()는 사용자 모드에서 커널의 읽기 처리로 넘어갈 때 이 경계를 지난다. - 파일 디스크립터File Descriptor
- 프로세스가 열어 둔 파일이나 소켓을 찾을 때 사용하는 음이 아닌 작은 정수다.
read()에 전달한fd를 출발점으로 커널이 실제 입출력 대상을 찾는다. - 가상 메모리Virtual Memory
- 프로세스가 사용하는 가상 주소를 물리 메모리와 연결하고 접근을 보호하는 메모리 관리 방식이다.
buffer는 현재 프로세스의 가상 주소 공간에서 데이터를 받을 위치를 가리킨다. - CPU 스케줄링CPU Scheduling
- 운영체제가 실행 가능한 작업 가운데 다음 실행 대상을 선택하고 CPU 시간을 배분하는 일이다. 블로킹
read()를 호출한 스레드가 입출력을 기다리면 다른 실행 가능한 스레드가 CPU를 사용할 수 있다. - read 시스템 콜read System Call
- 파일 디스크립터가 가리키는 대상에서 지정한 최대 바이트 수만큼 읽어 사용자 버퍼로 옮기는 Linux 시스템 콜이다. 성공 시 실제 바이트 수, 입력의 끝에서는
0, 오류에서는-1을 반환한다. 요청한 크기보다 적은 데이터만 반환해도 오류라고 단정할 수 없다.